Google dice que no toda página debe estar en el índice
La guía de spam de Google del 26 de octubre ordena noindex por defecto para páginas compartibles, salidas generadas y herramientas. Esta es la auditoría.
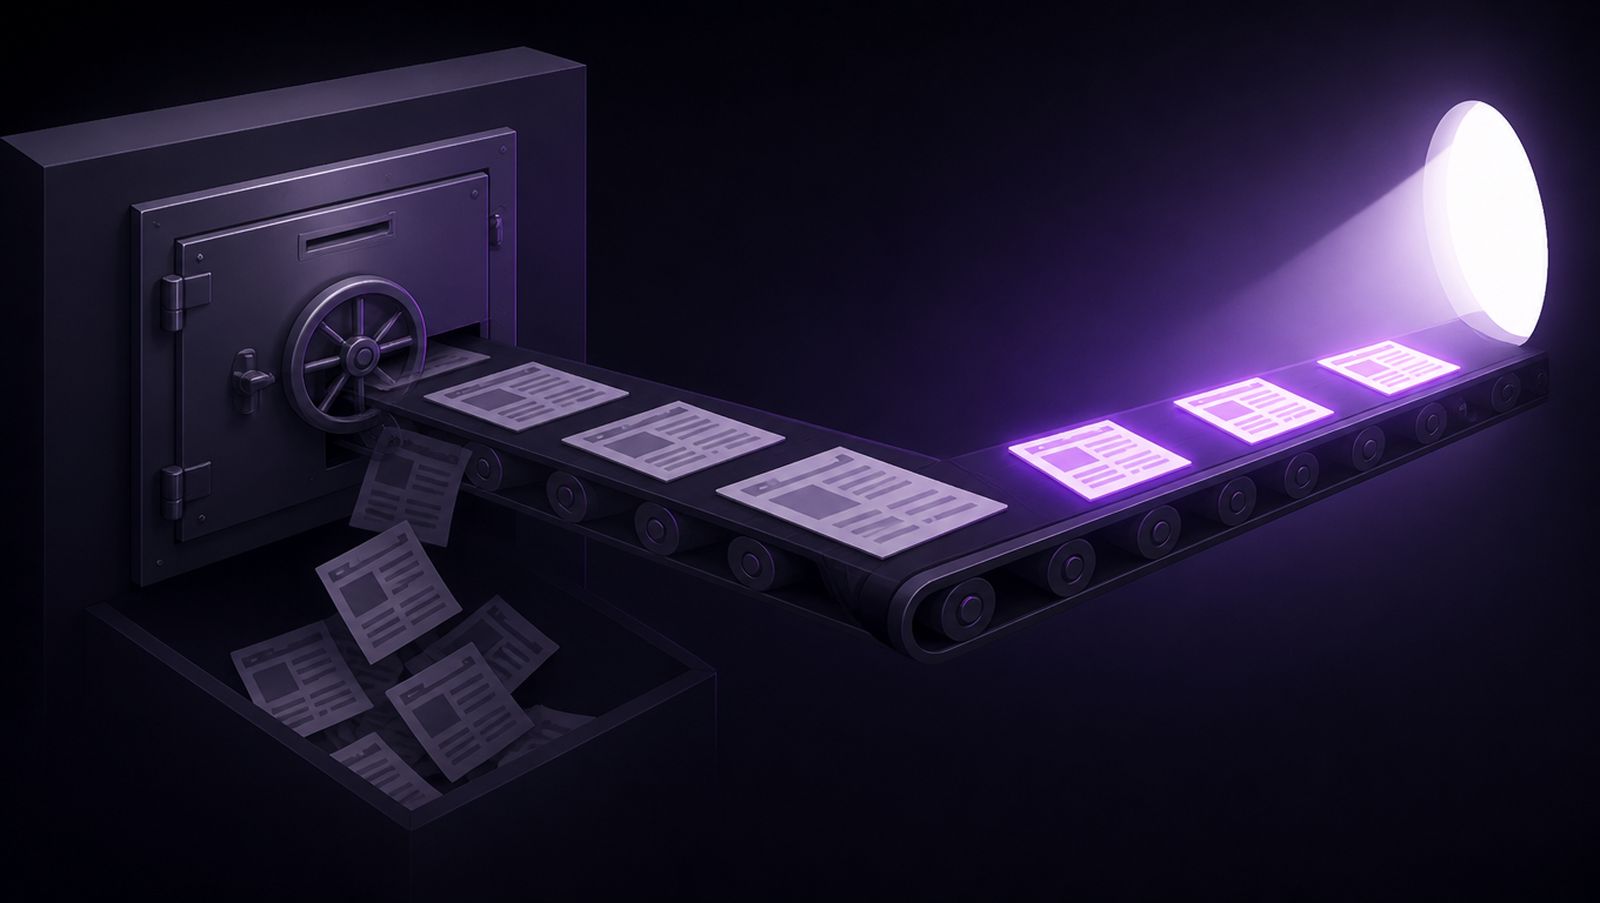
El 26 de octubre Google agregó una sección nueva a su guía de prevención de spam: "Indexa solo el contenido pensado para Search". La regla es directa. Si tu servicio deja que las personas creen páginas para compartir, salidas generadas o herramientas interactivas, decide si cada página existe para que la encuentren o solo para que la abra quien tiene el enlace. Las páginas creadas para compartir, colaborar o servir de utilidad reciben noindex por defecto, con una etiqueta robots meta o una cabecera X-Robots-Tag.
Esa frase suena distinto de lo que sonaba hace dos años, porque el índice ya no es solo una lista de enlaces azules. Es la materia prima que las superficies de IA de Google citan. Una página que dejas en el índice ahora compite por el pasaje que un motor de respuesta lee en voz alta.
Qué cambió realmente Google
La actualización vive en la guía Prevent user-generated spam on your site and platform de Google, y el changelog de Google la confirma con fecha del 26 de octubre. Dos agregados importan.
El primero es la sección misma. Su lenguaje es poco habitual: las páginas "creadas para compartir directamente, colaborar o servir de utilidad en lugar de búsqueda pública" deben recibir noindex o quedar fuera del rastreo por defecto. La guía hablaba de cuentas spam y formularios de comentarios. Ahora nombra la arquitectura: "herramientas que permiten a los usuarios publicar páginas compartidas, contenido generado o aplicaciones web".
El segundo es el consejo de monitoreo. Google ahora pide a los equipos medir la creación y la indexación a nivel de plataforma y configurar alertas por anomalías, incluido "un pequeño número de usuarios que genera gran parte de las URLs indexables". Esa frase está escrita para quien opera sistemas donde los usuarios crean URLs a voluntad. Search Engine Journal y Search Engine Roundtable cubrieron el cambio el mismo día.
Esto va mucho más allá de las plataformas con usuarios
Tentará archivar esto como un consejo para empresas SaaS con cuentas de usuario. No lo hagas. El principio de abajo es más viejo que la sección: un lugar en el índice debería ganarse con intención de descubrimiento. Cualquier sitio que genera URLs tiene páginas en el índice que nunca se escribieron para que un desconocedor las encuentre.
Enlaces para compartir, borradores con vista previa, reportes exportados, confirmaciones de reserva, resultados de búsqueda internos, etiquetas que nadie planeó, contenido de usuarios que se registraron ayer: en las auditorías que hacemos, esa capa es invisible para quienes poseen el sitio, porque nadie escribió esas plantillas y nadie reporta sobre ellas. Se acumulan hasta que el conteo de indexadas se ve sano y la gráfica de tráfico no.
Google acaba de escribir la regla por defecto para esa capa, y dice que no.
La auditoría: decide por plantilla, no por URL
Revisar URLs una por una es el error. Decide a nivel de plantilla y toda la clase se mueve junto.
| Tipo de página | Decisión por defecto | Por qué |
|---|---|---|
| Enlaces y documentos para compartir | noindex | El enlace es el modelo de acceso. Descubrirlo no le aporta nada al remitente y expone contenido pensado para un público elegido. |
| Vistas previas generadas, exportaciones, páginas de reporte | noindex | Utilidad, no descubrimiento. Quien la necesita ya tiene la URL. |
| Contenido de usuarios nuevos o sin reputación | noindex hasta que la cuenta tenga reputación | Google sugiere exactamente esto en la misma guía. Deja que los colaboradores probados se indexen; no permitas que cuentas de un día creen URLs indexadas. |
| Resultados de búsqueda internos, archivos de etiquetas y filtros | noindex | El caso clásico de indexación excesiva, sin cambios con todo esto. |
| Cuentas, reservas y páginas de confirmación | noindex | Un número de confirmación no es para extraños. |
| Páginas que responden una consulta que tus compradores hacen | Mantener indexadas | La regla ordena por intención, no por volumen. |
Falta una columna a propósito: cuántas páginas produce cada plantilla. Ese número pertenece a tu propia auditoría, no a un artículo publicado.
Conseguir la lista es la parte aburrida, y ahí es donde los equipos se estancan. Exporta el informe de indexación de páginas, pasa las URLs a una hoja de cálculo y agrúpalas por el segmento de ruta que identifica la plantilla: /share/, /preview/, /export/, /search, /u/, lo que use tu stack. Diez minutos de agrupación dicen más que una hora leyendo URLs de una en una, porque la decisión nunca trata de una página. Trata de la regla que produce las próximas mil.
La trampa que hace fallar la regla
La sección de Google ofrece dos mecanismos: noindex o bloquear el rastreo en robots.txt. Los equipos escuchan "bloquéalo" y llegan primero a robots.txt. Ese es el orden equivocado.
Si robots.txt impide que Googlebot cargue una página, Google nunca lee el noindex de esa página. Una URL bloqueada para rastrear puede terminar en el índice como una entrada sin título, sin descripción y sin contenido, y aun así te resta. La instrucción que querías dar nunca llegó.
Así que usa noindex en una página que Google pueda rastrear siempre que la página deba salir del índice. Reserva robots.txt para lo que sí sabe hacer: impedir que los rastreadores carguen rutas que nunca deberían leerse. La distinción completa, incluido lo que robots.txt no puede hacer contra un motor de respuesta, está en Los rastreadores de IA pueden leerte y aun así no citarte.
Qué cambia esto para la búsqueda con IA
Noindex ahora es una decisión de citación. AI Overviews y AI Mode trabajan sobre el índice de Google. Una página fuera del índice no puede ser citada por ellas, sin importar qué tan bueno esté el pasaje. El interruptor que antes era mantenimiento decide ahora si un motor de respuesta puede ver la página.
Las URLs de utilidad compiten con tus mejores páginas. Cada una que dejas indexada consume rastreo, entra en la selección de pasajes y aparece en el reporte que muestras a tu equipo. Limpiar el índice antes era higiene. Ahora es parte de la razón por la que tus páginas comerciales son citadas.
Los motores de terceros siguen sus propias reglas. ChatGPT y Perplexity rastrean con sus propias políticas; noindex gobierna a Google. No asumas que una sola instrucción cubre a todos, porque eso es otra auditoría.
La composición del índice también es una de las pocas variables que controlas mientras esperas a que Google cambie algo. Ese mismo argumento hicimos al leer el despliegue de septiembre, y por eso nuestra clasificación de diagnóstico viene antes de tocar contenido.
Qué hacer esta semana
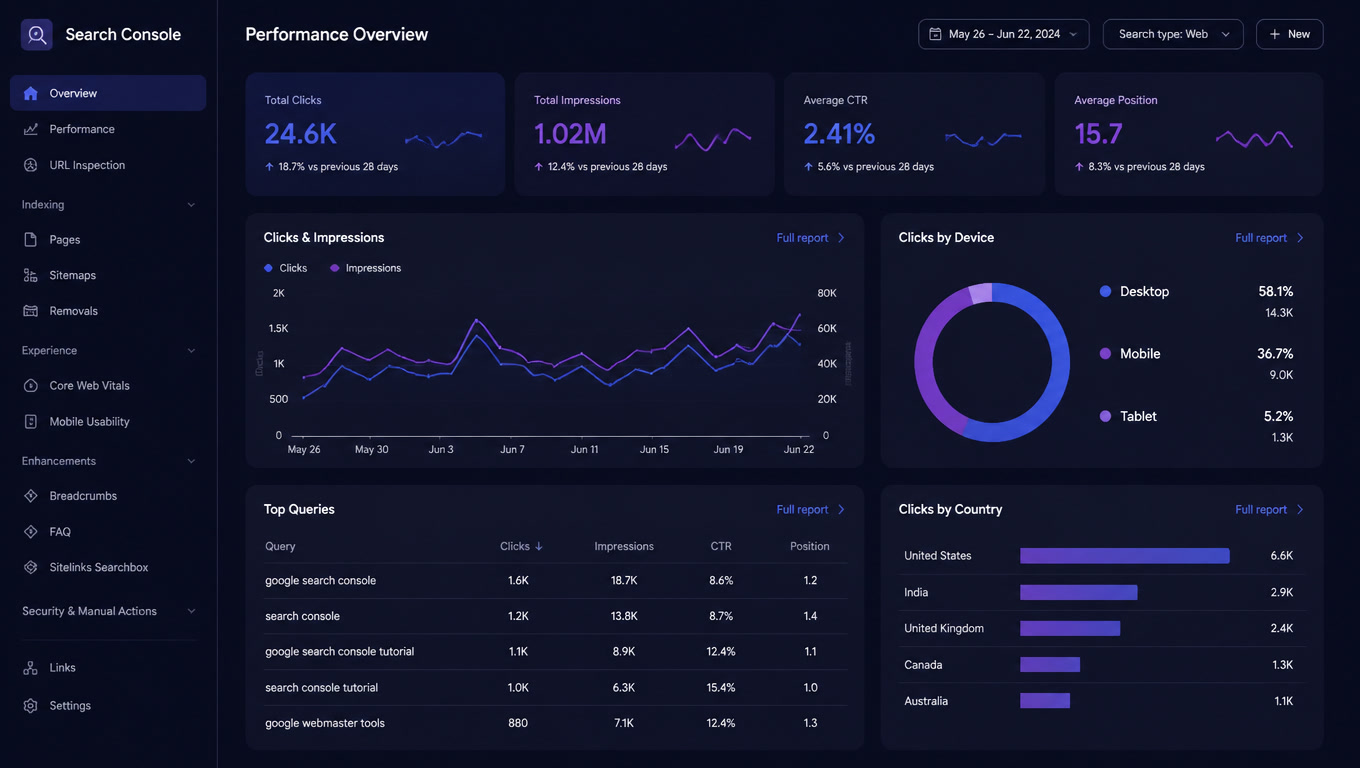
- Abre el informe de indexación de páginas en Search Console y agrupa las URLs indexadas por la plantilla que las produjo.
- Asigna una decisión por plantilla: mantener,
noindexo bloquear. Escríbela para que el próximo lanzamiento no la deshaga. - Prefiere
noindexsobre robots.txt siempre que la página deba salir del índice, y comprueba que la etiqueta sí llegue a Googlebot. - Vuelve al informe en una semana. El conteo de indexadas debería bajar. Si una página que atrae atención se movió con él, clasificaste mal: corrige la clase, no la URL.
- Si la auditoría es la parte que nunca alcanzas, es lo primero con lo que empieza nuestro equipo de SEO y GEO.
Google trazó una línea entre las páginas hechas para personas que envían enlaces y las páginas hechas para máquinas que responden preguntas. La mayoría de los sitios nunca trazó esa línea ellos mismos. La guía ahora da por hecho que la trazarás.
Preguntas Frecuentes
¿Bloqueo el rastreo o uso noindex para sacar una página de Google?
Usa noindex en una página que Google pueda rastrear, con una etiqueta robots meta o una cabecera X-Robots-Tag. Si robots.txt impide que Googlebot cargue la página, Google nunca lee el noindex y la URL puede quedar indexada como una entrada sin título, sin descripción y sin contenido.
¿El noindex saca una página de AI Overviews y AI Mode?
Sí, en las superficies de IA de Google. AI Overviews y AI Mode trabajan sobre el índice de Google, así que una página marcada noindex no puede ser citada por ellas. Los motores de terceros como ChatGPT o Perplexity rastrean con sus propias políticas, así que noindex no los gobierna.
¿Cómo encuentro las páginas que no deberían estar indexadas?
Empieza con el informe de indexación de páginas en Search Console y agrupa las URLs indexadas por plantilla en lugar de revisar una por una. Enlaces para compartir, vistas previas generadas, exportaciones, confirmaciones de reservas, resultados de búsqueda internos y contenido de usuarios nuevos son los habituales, y una decisión por plantilla mueve toda la clase.