Los rastreadores de IA pueden leerte y aun así no citarte
robots.txt decide quién puede leer tus páginas. No decide si una respuesta de IA te cita. Qué cambia cada directiva y cómo comprobarlo.
Una regla de robots.txt es un interruptor de acceso, no de visibilidad. Decide si un rastreador puede leer tus páginas; no tiene voto en si un motor de respuesta te cita. Google reafirmó esa frontera el 21 de octubre, y confundir los dos niveles es el error caro más común en búsqueda con IA hoy.
Gary Illyes y Cherry Prommawin publicaron el 21 de octubre el segundo episodio de la serie de videos Non-Canonical Cabinet de Google, esta vez sobre qué se puede poner realmente en un robots.txt. La frase que importa para quien contrata trabajo de GEO: robots.txt "es un protocolo de preferencia de acceso. Solo le dice a los bots: puedes rastrear esta página, o no deberías rastrear esta otra. No dicta qué hace un sistema con los datos después de ya haberlos rastreado". Y añadió lo que todos olvidan: no es un mecanismo de seguridad, y bloquear el rastreo de una página es distinto de pedirle a una empresa que no entrene con contenido que ya obtuvo.
En abstracto la distinción suena obvia. Luego ves cómo aparece en configuraciones reales, incluida la nuestra.
Tres interruptores que se fusionan en uno
Acceso de rastreo, extracción y citación son tres sistemas separados con tres dueños distintos.
Acceso de rastreo es robots.txt y tu servidor. Un rastreador envía un user-agent, tu archivo responde sí o no, y el rastreador recibe el HTML o se va. Es la única capa que robots.txt toca.
Extracción es lo que el rastreador hace con el HTML una vez que lo tiene: si se renderiza JavaScript, si el dato estructurado se interpreta, si el pasaje que responde la pregunta está en el texto rastreable o enterrado en una imagen. Una página puede ser completamente rastreable y seguir siendo opaca para un sistema que la lee, porque la respuesta no está en el texto que recibió.
Citación es una decisión tomada dentro del motor de respuesta, después de la recuperación, contra factores que ningún dueño de sitio controla directamente: si tu pasaje coincide con la consulta, si tu entidad es inequívoca, si fuentes independientes corroboran lo que afirmas. El acceso es precondición de todo esto apenas en lo obvio, y en nada más.
La documentación de crawlers de Google respalda la separación. Las preferencias expresadas para el user-agent Googlebot afectan a Google Search y sus funciones; las preferencias para un rastreador de IA como GPTBot o ClaudeBot afectan solo a la capacidad de ese rastreador para leer tus páginas. Nada en el archivo llega a las respuestas de ChatGPT, a las citas de Perplexity ni al origen de fuentes de AI Mode.
Nuestra propia configuración, y lo que nos compra
Operamos mintec.co con los rastreadores de IA bienvenidos explícitamente. Esta es toda la sección relevante de nuestro robots.txt tal como se sirve hoy:
User-agent: *
Allow: /

# AI Crawlers — explicitly welcome
User-agent: GPTBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Bytespider
Allow: /

User-agent: cohere-ai
Allow: /

User-agent: Applebot-Extended
Allow: /

Sitemap: https://mintec.co/sitemap-index.xml
Siete rastreadores de IA con nombre, cada uno con su Allow explícito. También servimos un llms.txt que resume quiénes somos, qué vendemos y dónde está la prueba. Por la lógica que aplican la mayoría de los equipos, deberíamos estar citados por todas partes.
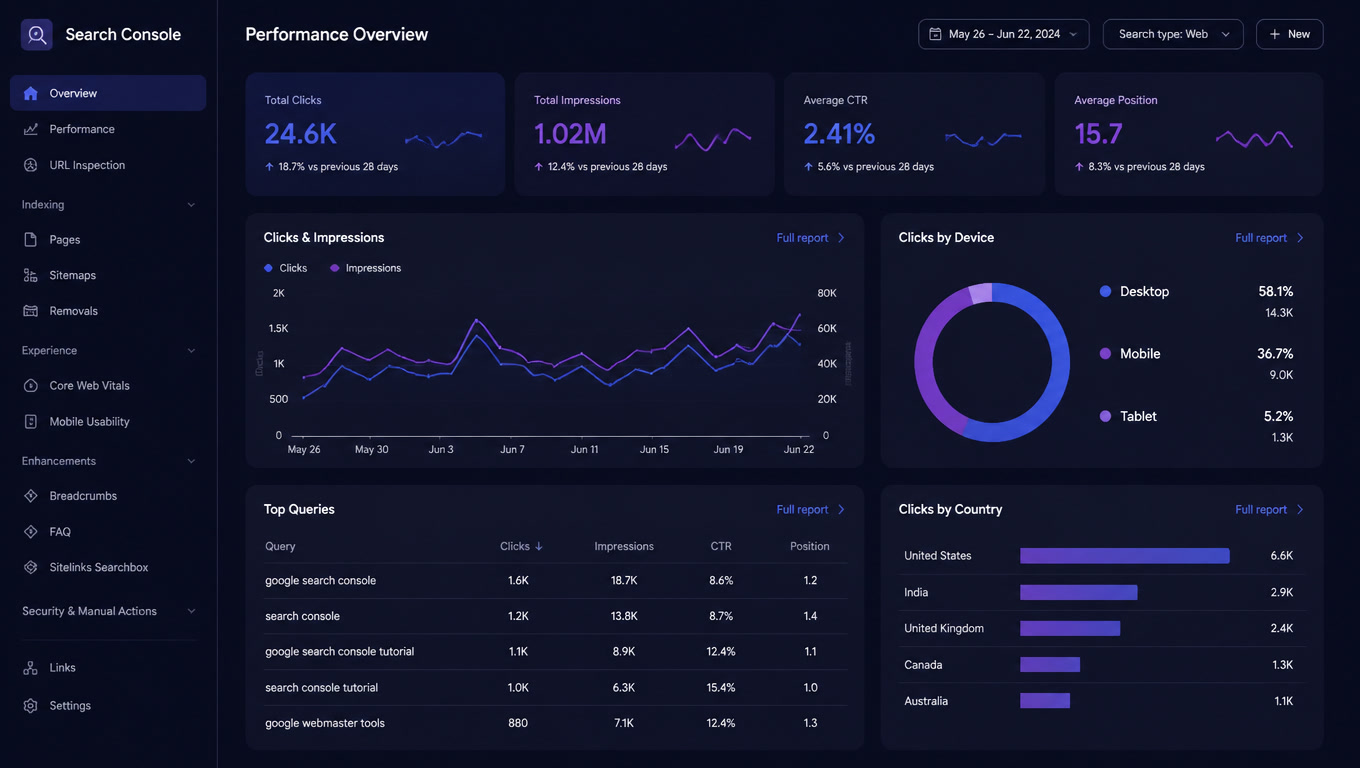
No lo estamos, y podemos medir la distancia. En los 28 días del 21 de septiembre al 19 de octubre, nuestra propia propiedad en Search Console muestra dos de nuestras páginas de listado sumando 73,400 impresiones y 548 clics entre ambas: un CTR de 0.75% en las posiciones 5.4 y 8.3. En la misma ventana, en la misma propiedad, la consulta "drupal canvas headless" convirtió 54 impresiones en 6 clics: 11.1% en la posición 5.9. Todas esas páginas son rastreables por cada bot que bienvenimos. El acceso nunca fue la variable. Incluso la posición apenas predijo los clics, y ninguna de las dos predice la citación, porque la citación se decide en otro sistema del que nuestro robots.txt no tiene asa.
Lectura honesta de esos números: una consulta amplia y una consulta técnica estrecha no son tráfico comparable, y el listado nunca iba a convertir como la consulta de Drupal. El punto es más estrecho y más difícil de esquivar: estar abierto a todos los rastreadores no movió nada por sí mismo. Hizo posible el rastreo; no hizo citable nada.
La tabla de directivas
Si auditas tu propia configuración, la pregunta por línea es: ¿qué cambia esta directiva, qué no cambia, y qué comprobación demuestra la diferencia?
| Directiva | Qué cambia | Qué no cambia | La comprobación que lo demuestra |
|---|---|---|---|
User-agent: GPTBot + Allow | El rastreador de OpenAI puede leer tus páginas para sus productos | Si ChatGPT te cita en una respuesta concreta; si OpenAI puede entrenar con contenido que ya tiene | Registros de bots del CDN o del servidor con hits de GPTBot, más tu propio registro fechado de citaciones en consultas prioritarias |
User-agent: ChatGPT-User + Allow | Rastreos disparados por el usuario: cuando alguien pregunta a ChatGPT por ti y este lee tu página en vivo | Si la respuesta resultante te nombra o te enlaza | Registros del servidor con peticiones ChatGPT-User, cruzados contra las mismas consultas de tu registro de citaciones |
Disallow en cualquier rastreador de IA | Un bot complaciente deja de rastrear las rutas bloqueadas | No desentrena un modelo, no saca tu página del índice de Google y no obliga a scrapers que ignoran robots.txt | Los rastreos caen en tus registros; tu cobertura de índice en Search Console no se mueve, y ese es el resultado esperado, no un error |
llms.txt | Existe un archivo en una ruta convencional que algunos rastreadores podrían leer como contexto | No es una directiva. Ningún rastreador está obligado a leerlo, nada lo hace cumplir, y no tiene efecto por sí solo en ranking ni en citación | No existe ninguna. Trátalo como un resumen para máquinas que deciden mirar, no como un interruptor |
Meta noindex o X-Robots-Tag | Saca la página del índice de Google, una palanca completamente distinta | No impide que un rastreador que ya permitiste lea la página, y no elimina copias de terceros | URL Inspection en Search Console; los bloqueos de robots.txt no aparecen ahí, y así distingues una cosa de la otra |
La cuarta fila merece una pausa. Publicamos a finales de julio un manual de implementación de llms.txt, y el archivo sigue valiendo la pena como resumen legible por máquinas. El manual de llms.txt explica cómo escribir uno. Lo que no es, es una palanca de citación, y cada semana alguien nos pregunta si agregarlo mueve su visibilidad en IA. No lo mueve. Nada lo hace cumplir, y los rastreadores que podrían leerlo deciden por su cuenta si el contenido vale algo.
Lo que sí mueve las citaciones
Tres palancas, ninguna en robots.txt.
Claridad de entidad. Para que un motor de respuesta te cite, primero tiene que estar seguro de qué empresa eres. Eso significa tu nombre, tu categoría y tu ubicación dichos igual en tus páginas de servicio, en tu schema Organization y en los perfiles de terceros que te describen. Cuando esos discrepan, el motor se acoge a la duda o cita a otro. Es trabajo sin glamour y es lo que más determina si eres citable en absoluto.
Corroboración de terceros. Los motores contrastan tus afirmaciones con lo que fuentes independientes dicen de ti. Una descripción consistente de tus servicios en un directorio de socios, una página de asociación o una mención fechada pesa más en citación que una décima página tuya repitiendo lo mismo. Por eso el trabajo GEO se cruza más con relaciones públicas que con SEO técnico.
Un registro fechado a nivel de consulta. Es la pieza que casi nadie guarda, y es lo único que convierte "creo que nos están citando" en evidencia. El formato que usamos, cada semana, sobre un juego fijo de consultas prioritarias:
consulta | fecha | superficie de IA | ¿hubo respuesta? | ¿citaron la marca? | camino al clic
Seis columnas, una fila por consulta, por superficie y por semana. No buscas crecimiento; buscas la primera semana en que una superficie deja de citarte, y si el patrón coincide con un cambio de contenido, una publicación de un competidor o nada que hayas hecho tú. La superficie importa porque se comportan distinto: AI Mode y los AI Overviews clásicos no son la misma superficie, y explicamos por qué esa distinción rompe los reportes en AI Mode y AI Overviews no son lo mismo. Cómo cuenta Search Console las posiciones cuando hay una respuesta de IA es un problema de medición aparte, cubierto en cómo Search Console cuenta las posiciones de IA. Y si tu pregunta hoy es si tus visitantes pueden desactivar los AI Overviews, eso es una configuración del lector, no de tu sitio. Ver cómo apagar los AI Overviews.
La conclusión que vale la pena citar
Abre tu robots.txt, da la bienvenida a todos los rastreadores que quieras y luego olvídate. Es un archivo de higiene, y tratarlo como un proyecto de visibilidad es cómo los equipos terminan midiendo lo equivocado durante un año. El trabajo de citación es claridad de entidad, corroboración y un registro que de verdad lleves. Si quieres un segundo par de ojos sobre el tuyo, ese es el servicio de SEO y GEO que corremos en Mintec — empezamos por el registro, no por el archivo.
Preguntas Frecuentes
¿Bloquear un rastreador de IA me saca de las respuestas de IA?
No. robots.txt es una preferencia de acceso, y la documentación de Google dice explícitamente que "no es un mecanismo para sacar una página de Google": las páginas bloqueadas en robots.txt pueden seguir indexadas si otros sitios enlazan a ellas. Un rastreador que bloqueaste también puede citarte desde una fuente externa, una página de un socio o datos que obtuvo antes de la regla. Para sacar una página del índice necesitas noindex; para que una empresa deje de usar contenido que ya tiene, necesitas una vía contractual o legal, no una línea de robots.txt.
¿Cómo detecto si una respuesta de IA se llevó el clic?
Search Console no te lo dice: reporta la consulta, las impresiones, la posición y el CTR, pero nunca marca que hubo una respuesta de IA. El método que funciona junta dos lecturas: el CTR por consulta con posición estable en una ventana de 28 días, más un registro fechado donde abres tus consultas prioritarias y anotas si apareció una respuesta de IA, si citaron tu marca y cómo quedó el camino al clic. Nosotros llevamos ese registro cada semana con nuestro propio dominio; el formato está en la última sección.