Video IA de 10 minutos: cuando la longitud deja de ser el cuello de botella
En 12 días de octubre, cuatro lanzamientos rompieron el techo del video IA: Higgsfield supera los 10 minutos con GPT-6 Astra y VideoGen genera 10 minutos desde un prompt. Qué cambia en producción, cuánto cuesta un intento real y qué se rompe primero.
El video IA superó los 10 minutos, y no fue por un render más potente: en 12 días de octubre, cuatro anuncios consecutivos mostraron que el techo de largo dejó de ser un problema de generación para convertirse en uno de planificación de planos — y el cuello de botella real se movió al control de calidad y a la entrega web. Higgsfield produce videos de más de 10 minutos con GPT‑6 Astra (13 de octubre), VideoGen anunció Model 1: 10 minutos desde un único prompt (19 de octubre), Synthesia puso en beta a Syren, que escribe el video como código (9 de octubre), y Vidu Q4 Preview llegó con 4K de 10 bits y precio público por segundo (7 de octubre). Si produces video para la web, la consecuencia práctica no es "genera más largo": es que la unidad de trabajo sigue siendo la escena, y el archivo largo pasa a ser tu maestro, no tu asset.
Los 12 días que rompieron el techo
En agosto, cuando cubrimos Seedance 2.5 y el formato de una sola toma, el techo de una pasada nativa era de 30 segundos. Ese techo no se estiró: se esquivó. Ninguno de los anuncios de octubre genera 10 minutos en un render continuo; todos planifican el video como una secuencia de planos y portan contexto de plano a plano.
| Lanzamiento | Fecha | Qué anuncia | Mecanismo | Precio público |
|---|---|---|---|---|
| Vidu Q4 Preview (Shengshu) | 7 oct | Producción "de verdad": 4K, 10 bits, voz de referencia | Hasta 15 imágenes de referencia por escena; voz de personaje consistente | $0.045/s en 540p → $0.39/s en 4K |
| Syren by Synthesia (beta) | 9 oct | El agente es el editor: describe y el video se construye en vivo | Escribe el video como código; motor de render propio en el navegador; edición por chat | Créditos por uso (planes existentes) |
| Higgsfield + GPT‑6 Astra (OpenAI) | 13 oct | Videos de más de 10 minutos | Agentes creativos que llaman herramientas externas (incluido modelado 3D) para mantener consistencia | No publicado |
| VideoGen Model 1 | 19 oct | 10 minutos desde un prompt, con planos que portan contexto | "AI thinking harness" que resuelve guion, planos y ritmo; jueces LLM en dos velocidades | Afirma >50 % más barato que Seedance 2.5 y Gemini Omni Flash (sin benchmark externo aún) |
Dos lecturas de marketing hay que descartarlas de entrada. Primera: VideoGen dice que Model 1 alcanza "cerca del 80 %" de la calidad de Seedance 2.5 — sin benchmark publicado, y la propia AI Affairs que cubrió el lanzamiento confirma que no tuvo acceso al modelo. Segunda: "10 minutos" no es "10 minutos útiles": la promesa real de estos sistemas es la continuidad de personajes y locaciones entre planos, que es lo que hacía inviable el video largo con IA hasta ahora.
La longitud no se genera: se planifica
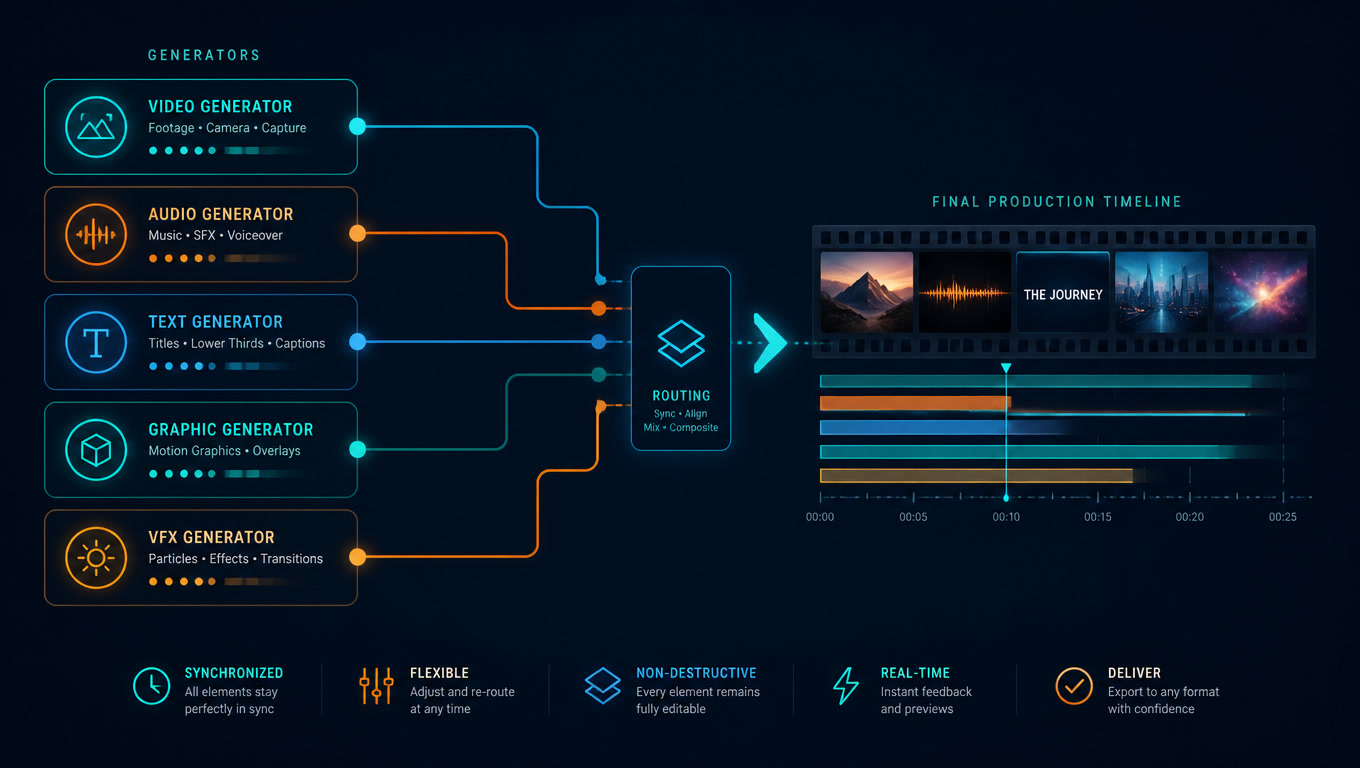
La diferencia técnica entre julio y octubre es quién decide los cortes. En una pasada nativa como la de Seedance, el modelo decide internamente y tú recibes un plano cerrado de 30 segundos. En los modelos largos, un sistema de planificación — el "thinking harness" de VideoGen, los agentes con herramientas de Higgsfield — descompone el prompt en una secuencia de planos y luego genera cada uno con el contexto de los anteriores pegado al prompt.
Para un equipo de producción esto cambia dónde vive el riesgo. El plan de planos se puede leer, corregir y reejecutar por partes: si el plano 7 falla, repites el plano 7, no los diez minutos. Ese es, en la práctica, el motivo por el que el formato largo se volvió producible: la unidad de fallo es el plano, aunque la unidad de entrega sea el archivo. En nuestro pipeline de producción multi‑modelo ya trabajábamos con esta idea — enrutar plano por plano al modelo que mejor le va — y los modelos largos la confirman en vez de reemplazarla.
Syren apunta a otra capa del mismo problema: en vez de planos, escribe el video como código y lo renderiza en vivo en el navegador. Si usas motion graphics y avatares corporativos, el "archivo maestro" deja de ser un MP4 y pasa a ser un documento reproducible que puedes regenerar con un cambio de copy. Para video de marca con actualizaciones frecuentes, eso es más interesante que los 10 minutos.
Qué se rompe primero: el framework de cuello de botella
Cuando el techo de largo desaparece, cinco cosas se redistribuyen. Este es el mapa que usamos para decidir dónde poner horas de equipo en un proyecto de video largo:
| Capa | Antes (techo ~30–60 s) | Ahora (10+ minutos) | Dónde duele primero |
|---|---|---|---|
| Consistencia | Se resolvía en un plano | Se decide entre planos: vestuario, luz, voz, encuadre | QC visual plano por plano |
| Superficie de revisión | 30 s, una pasada | 600 s, decenas de planos | Horas humanas, no minutos |
| Costo por intento | Dólares por pieza | Decenas a cientos de dólares por render aceptado | Presupuesto de iteración |
| Edición | Timeline de recorte | Reejecución de planos sueltos + capítulos | Gestión de versiones |
| Entrega web | Un hero de video factible | Archivo de 450–600 MB sin estrategia | Core Web Vitals y banda del usuario |
La fila que casi todos subestiman es la segunda. Revisar 600 segundos de video generado — buscando inconsistencias de personaje, labios fuera de sincronía, texto de interfaz inventado — toma órdenes de magnitud más que revisar un clip de 30 segundos, y ese tiempo no se automatiza del todo: los jueces LLM de VideoGen ayudan, pero hoy la decisión de "esto sale a producción" sigue siendo humana.
El número que importa: cuánto cuesta un intento
Con las tarifas públicas de Vidu Q4 Preview, un render aceptado de 10 minutos (600 segundos) cuesta $27 en 540p y hasta $234 en 4K. Como referencia de presupuesto: cinco iteraciones de un mismo guion en 4K pasan de los $1,100 de generación antes de que exista un solo archivo de entrega. La matemática de tarifa por segundo que publicamos en agosto se mantiene, pero el largo multiplica el error: donde un hero de 30 segundos te permitía equivocarte barato, un maestro de 10 minutos obliga a validar el plan de planos en 540p antes de pagar el render fino. Draft barato arriba, render caro solo cuando el plan ya está aprobado — esa es la única combinación que cuadra.
Y sí, el descuento del 30 % de Vidu hasta el 30 de noviembre en image-to-video y reference-to-video ayuda al pilot, pero no cambia la estructura del costo: el costo vivo es el ciclo de revisión.
Un archivo de 10 minutos no es un asset web
Aquí es donde el video de producción y el desarrollo web se cruzan, y donde más errores vemos. Un maestro de 10 minutos en H.264 a 1080p con un bitrate estándar de 6–8 Mbps pesa entre 450 y 600 MB. Ninguna página de aterrizaje sobrevive a eso cargado de forma directa; el usuario promedio en móvil no lo descarga, y tu LCP se convierte en una anécdota. Ya lo cubrimos en el playbook de carga diferida de video y audio y en cómo incrustar video de IA sin destruir el rendimiento, y el principio escala al formato largo sin cambios: poster primero, carga diferida real, y el video solo después de interacción o de que el viewport lo permita.
La regla que aplicamos: genera largo, entrega por capítulos. El maestro de 10 minutos es material de archivo y fuente de recortes; la web recibe segmentos de 40–90 segundos con poster propio, más un índice de capítulos para quien quiera el completo (con <track> de subtítulos desde el día uno — no es opcional, es parte del QC). Un encode AV1 del maestro reduce el peso entre un 30 y un 50 % al mismo valor visual, y justifica la pena justo cuando el contenido completo sí se consumirá en la página.
Qué estamos haciendo en Mintec
Nuestra postura hoy, en concreto: el formato largo de IA sí entra en producción para explicadores, tutoriales, contenido de canal y demos, con plan de planos aprobado antes de pagar render fino y revisión humana por plano. No entra todavía como pieza cinematográfica sin QC, ni como archivo único incrustado en una landing. Y hay un caso de uso que preferimos rechazar: cuando el "video de 10 minutos" en realidad necesita continuidad editorial estricta — entrevistas, narración con datos vivos — un maestro generado y luego cortado sigue siendo más barato y más controlable que pedirle al modelo los 10 minutos de corrido.
El techo de longitud ya no es la pregunta. La pregunta ahora es cuánto te cuesta revisar lo que generas — y eso, por ahora, sigue siendo humano.
Preguntas Frecuentes
¿Cómo genera un modelo 10 minutos de video si cada pasada dura segundos?
No los genera en una sola pasada. Los modelos que rompieron el techo de octubre planifican el video como una secuencia de planos: un sistema de planificación resuelve guion, diálogo, planos y ritmo, y cada plano se genera portando el contexto de los anteriores (personajes, locaciones, detalle). La longitud viene de la planificación, no de un render continuo más largo.
¿Cuánto cuesta generar 10 minutos de video IA?
Con las tarifas públicas de Vidu Q4 Preview: unos $27 en 540p y hasta $234 en 4K por cada render aceptado de 600 segundos ( $0.045/s y $0.39/s respectivamente). A ese costo por intento hay que sumar las iteraciones de QC: en la práctica, el presupuesto de un video largo de IA lo define cuántas veces revisas y repites, no cuánto tarda el render.
¿Ya se puede usar video IA de 10 minutos en producción para clientes?
Sí, para formatos donde la continuidad se controla por escena — explicadores, tutoriales, contenido de canal, demos de producto — con revisión humana plano por plano. Todavía no para piezas que exigen continuidad cinematográfica sin una pasada de QC: la consistencia entre planos es el fallo más caro, y es exactamente donde fallan los modelos largos.