Reddit está cerrando la puerta por la que llegan las citas de IA
Reddit perdió más de un millón de referidos de búsqueda por semana y prueba un sitio solo para registrados. Las citas de IA ya son un contrato.
El jueves Reddit informó a sus accionistas que el tráfico procedente de búsqueda cayó en más de un millón de referidos por semana en promedio durante octubre, y que este trimestre probará una versión del sitio solo para usuarios registrados en mercados selectos fuera de Estados Unidos. Ese mismo día, en un evento de Digiday en Londres, el director de innovación de People Inc. describió el paso de sus socios de IA del rastreo web a una API propia, porque "el 90% del contenido es basura pensada para que la lea un navegador, no un agente". Una empresa está cerrando el rastreo. La otra lo está sustituyendo por algo más estrecho y más barato. Las dos te están diciendo lo mismo sobre el supuesto en el que está montado tu programa de GEO.
La respuesta corta: el acceso a las fuentes que lee un motor de respuestas está pasando de "rastreo público" a "permiso concedido", y ese permiso ya tiene condiciones, precio y fecha de vencimiento. Eso cambia lo que puedes auditar. No cambia lo que debes publicar: cambia lo que debes dejar de contar.
Lo que dice la carta de Reddit
El titular que circula es que AI Mode mató el tráfico de Reddit. El documento es más cuidadoso que la cobertura, y la diferencia importa si estás usando a Reddit como termómetro de cómo las superficies de IA tratan al resto de la web.
- El número: los referidos de búsqueda cayeron en más de un millón por semana en promedio durante octubre, después de un tercer trimestre en el que ese tráfico ya venía "significativamente a la baja".
- La proyección: si la caída sigue a ese ritmo, los usuarios activos diarios únicos podrían bajar en el cuarto trimestre un porcentaje de dos dígitos bajos desde una base de 130 millones.
- La atribución: el CEO Steve Huffman dijo que la parte más grande de su hipótesis de trabajo son los AI Overviews y AI Mode de Google. También nombró un segundo factor —contenido traducido automáticamente posicionándose peor, sobre todo fuera de Estados Unidos— y aclaró que Reddit no tiene visibilidad sobre si esto se comporta como una actualización de algoritmo normal o como algo permanente.
- El hueco: ni la carta ni la llamada con analistas reparten la caída entre esas dos causas. Quien publique una cifra única de "tráfico perdido por la IA" está citando algo que Reddit no dijo.
Y viene la parte que te toca. La prueba de login se presenta como una pregunta sobre cuánto contenido ve la gente antes del aviso de registro, incluida la que llega desde búsqueda. También es, en palabras de la propia carta, una forma de proteger el acceso al corpus de Reddit y de adaptarse a la regulación emergente. Huffman añadió que la gran mayoría del scraping ocurre por acceso sin sesión.
Lee esas frases juntas y no es un experimento de experiencia de usuario. Es una decisión sobre acceso al corpus vestida de experimento de producto, anunciada por la plataforma más dependiente de referidos de la web, un trimestre después de que el tráfico que la hacía valiosa empezara a caer.
El contramovimiento: una segunda puerta, construida a propósito
Mientras Reddit explicaba por qué podría cerrar la puerta principal, los medios construían una entrada lateral con cerradura.
People Inc. pasó del rastreo a buckets de Amazon S3 —que le permiten empujar actualizaciones y retractaciones— y ahora va hacia APIs propias que devuelven el texto del artículo en Markdown junto con autor, fecha de publicación, fecha de actualización y otras señales de procedencia. Forbes creó versiones en Markdown de sus reseñas de Vetted y una "capa MCP" al lado. The Economist experimenta con lo que Digiday llamó una web de dos carriles: el material fuera del muro de pago, más fácil de leer para agentes.
Dos estrategias opuestas, una misma aritmética. Un agente que lee tu HTML paga como tokens la navegación, el aviso de cookies, los enlaces relacionados y los espacios publicitarios. El medio no paga nada de eso y el lector lo paga todo. Así que el medio reduce la página a algo que un agente pueda costearse, y a cambio pide una relación durable en lugar de una visita.
Cloudflare ya había vuelto literal ese intercambio. Su función pay per crawl resucita el código HTTP 402 Payment Required: el rastreador presenta intención de pago en las cabeceras y recibe un 200, o recibe un 402 con el precio. El dueño del dominio elige permitir, cobrar o bloquear por rastreador, y Web Bot Auth evita que se falsifique la identidad del bot.
Los cuatro modos de acceso y lo que cuesta cada uno
Casi todo el consejo de GEO asume un único modelo: páginas públicas, rastreables y gratis. Ahora hay cuatro, y fallan de maneras distintas.
| Modo de acceso | Quién fija las condiciones | Qué recibe el lector | Qué le cuesta | Qué pierdes en la auditoría |
|---|---|---|---|---|
| Rastreo público | Tú, vía robots.txt y cabeceras | La página completa, otra vez en la siguiente visita | Tokens gastados en todo lo que no es la respuesta | Nada que leer de vuelta: no hay registro de que la cita ocurrió |
| Feed o bucket licenciado | Un contrato entre dos empresas | Texto limpio, más actualizaciones y retractaciones | Una tarifa por ítem o por periodo, más trabajo de integración | La visibilidad queda en el socio, no en ti |
| Acceso medido (402) | Tú, en el borde de la red | Una página, una petición, un precio | Se cobra por petición, lo que castiga el re-rastreo | Los registros viven en el edge, no en tu CMS ni en tu rank tracker |
| API para agentes o endpoint MCP | La plataforma que lo publica | Una respuesta tipada, no una página | Cómputo de su lado, autenticación del tuyo | Las citas suelen llegar sin URL que atribuir |
La cuarta fila es la que rompe los informes sin hacer ruido. Cuando un agente obtiene un dato de tu API y lo repite en una frase, muchas veces no hay enlace, ni referrer, ni sesión. Fuiste la fuente. No puedes verlo.
Dos números que esto rompe en tu panel
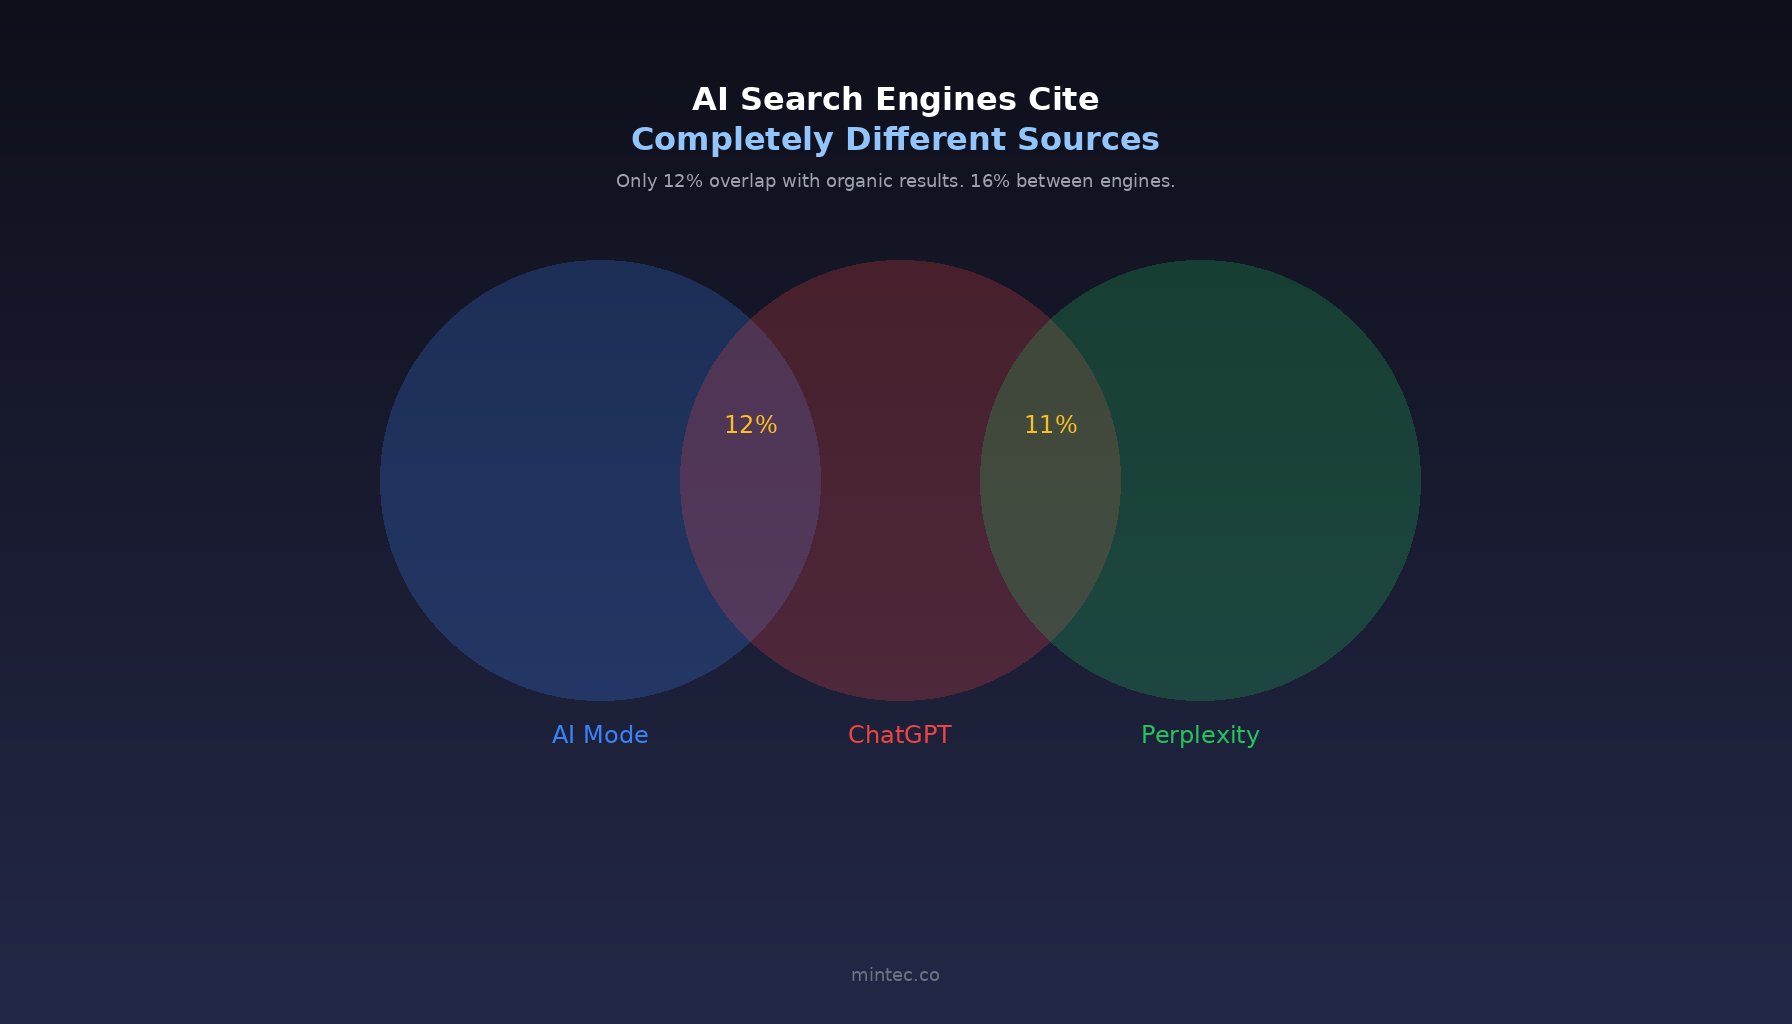
Primero: citas y clics son indicadores distintos, de sistemas distintos. Reddit es el caso más claro que existe, porque publicó las dos mitades: es uno de los dominios más citados en respuestas de IA y acaba de decirle a sus accionistas que el lado del clic cae más de un millón por semana. Si tu informe de GEO mete "visibilidad en IA" y "sesiones desde IA" en la misma tabla, una de esas filas no mide lo que mide la otra.
Segundo: Google no te da una superficie de IA que puedas filtrar. Search Console documenta los AI Overviews y AI Mode dentro del tipo de búsqueda Web, mezclados con los resultados clásicos y sin filtro para separarlos; además, cada enlace dentro de un AI Overview hereda la posición del bloque completo, que no es un ranking. En analítica, las visitas desde AI Mode suelen traer referrer de google.com y parecen orgánico normal. El tráfico de asistentes solo se identifica por su propio referrer.
Así que la versión honesta de "cuánto tráfico de IA recibimos" es: un conteo de referidos de asistentes, un número mezclado para las superficies de Google y un conteo de citas que armas a mano. Tres sistemas. Quien presenta un solo número está eligiendo cuáles dos esconder.
El mapa de acceso: una página, cinco filas
Este es el artefacto que construiría antes de tocar una sola pieza de contenido. Toma las cinco superficies que de verdad te citan —no las que te gustan— y anota una fila por cada una:
- Superficie — el lugar concreto donde aparece la cita, no "Google".
- Modo de acceso — uno de los cuatro de arriba.
- Condiciones — quién puede leerlo, bajo qué términos y cuándo se revisaron por última vez.
- Lectura de vuelta — ¿puedes reproducir esa cita tú mismo, cuando quieras, sin pedirle permiso a nadie?
- Rotación — qué tan rápido cambia el conjunto de fuentes citadas en esa superficie.
La regla que hace que la página valga la pena: una superficie que no puedes leer de vuelta es un punto ciego, no un canal. En el trabajo con clientes se repite el mismo fallo: los programas optimizan para superficies que nadie escribió, y la primera auditoría real encuentra citas que no se pueden reproducir, porque la página se citó desde una copia licenciada, o la respuesta usó una API, o el muro se levantó entre la línea base y la lectura.
Mapear cuesta horas, no meses. No mapear cuesta el trimestre que pasas optimizando una fuente que dejó de responder a los rastreadores en agosto.
La opinión: la cuota de citas es una métrica alquilada
El ranking, las sesiones y las conversiones asistidas son tuyos. Los puedes defender con tus propios registros. La cuota de citas se alquila a una entidad que puede cambiar sus condiciones en un trimestre, y que desde este mes empezó a hacerlo.
Por eso dividiría la línea de presupuesto de GEO en lugar de defender un número mezclado. Una mitad va a pagar acceso y procedencia: una versión de texto limpia, metadatos reales de autor y fecha de actualización, una política de acceso explícita en vez de una heredada, y la disciplina de escribir qué permite cada superficie. La otra mitad va a demanda propia —la lista de correo, la visita directa, el cliente que vuelve— porque eso no desaparece cuando una plataforma decide que quien lee sin registrarse es un rastreador.
La predicción incómoda: las superficies que te citen en 2027 van a ser, de forma desproporcionada, las que tengan un contrato detrás. Los contratos no vienen con checklist, así que la ventaja se la queda quien empezó a mapear el acceso este trimestre y no quien esperó un estándar.
Si quieres un segundo par de ojos sobre ese mapa, nuestro trabajo de SEO y GEO empieza con una auditoría de acceso y de citas antes de cualquier decisión de contenido. La mecánica relacionada ya está documentada aquí: por qué el permiso del rastreador y la cita son sistemas separados, y qué interruptor estás moviendo cuando bloqueas el entrenamiento de IA. Si tu sitio además tiene que atender agentes directamente, la decisión entre páginas y protocolos es donde arranca la conversación de reconstrucción.
El rastreo no va a desaparecer. Se está convirtiendo en uno de cuatro carriles, y los carriles se están poniendo precio mientras la mayoría de los equipos sigue discutiendo el conteo de palabras.
Preguntas Frecuentes
¿Un muro de registro en Reddit afecta mis citas en respuestas de IA?
De forma indirecta, y no puedes controlar en qué dirección. Si la mejor fuente para una consulta queda detrás de una pantalla de login, un motor de respuestas tiene tres salidas: citar una copia licenciada de ese contenido, citar otra fuente o eliminar la cita. Cualquiera de las tres ocurre fuera de tu visibilidad, y por eso depender de una sola superficie de alta autoridad es un riesgo que solo ves cuando mapeas tus citas por fuente.
¿Se puede separar el tráfico de AI Mode del orgánico en Search Console?
No. Google documenta los AI Overviews y AI Mode dentro del tipo de búsqueda Web del informe de rendimiento, mezclados con los resultados clásicos y sin filtro para separarlos. En analítica, las visitas desde AI Mode suelen traer referrer de google.com y parecen orgánico normal. Las superficies de asistente como ChatGPT o Perplexity solo se identifican por su propio referrer.
¿Qué tiene que ver el código HTTP 402 con el SEO?
El 402 Payment Required es el código que usa pay per crawl de Cloudflare para poner precio al acceso: el rastreador presenta intención de pago y recibe un 200, o recibe un 402 con el precio. El dueño del dominio elige permitir, cobrar o bloquear por rastreador. Convierte el acceso de los bots en un tema de facturación, no de permisos.