¿Un solo LLM o un ejército de agentes? La decisión que fija tu factura y tu tasa de fallo
Un agente solo acertó 28 de 28 veces; el enjambre falló 68%. Y aun así Anthropic midió +90% con multiagente. Cómo elegir la topología con datos, no con moda.
¿Un solo LLM o un ejército de agentes? La decisión que fija tu factura y tu tasa de fallo
Respuesta corta: empieza con un solo orquestador con herramientas. Un ejército de agentes solo se justifica cuando la tarea se puede partir en subtareas independientes, nadie necesita escribir en el mismo registro y el valor de cada tarea paga ~15x los tokens de un chat. Un agente solo acertó 28 de 28 veces en el estudio de McEntire (2026); el enjambre falló el 68% de las veces. Y aun así, el sistema multiagente de Anthropic superó al agente único por 90,2% — con 15x la factura de tokens. Las dos cosas son ciertas, y esa es exactamente la trampa.
La pregunta ya no es si los agentes de IA sirven. Es cuántos poner. En r/Entrepreneur, el hilo "Are you using one LLM or an army of agents?" acumuló 54 upvotes y 125 comentarios: gente operando agentes hace meses y sin saber si paga por arquitectura o por costumbre.
Nosotros los implementamos en CRMs reales este año, y la respuesta a clientes es siempre la misma: una caja en el diagrama, no diez. Te explico por qué, con datos.
Dos estudios serios que se contradicen — y por qué los dos tienen razón
En junio de 2025, Anthropic publicó su sistema de Research multiagente: un agente líder Opus 4 delegando en subagentes Sonnet 4 en paralelo. En su evaluación interna superó al agente único por 90,2%. Difícil de discutir.
Pero en el mismo post viene la factura: los agentes usan ~4x los tokens de un chat y los sistemas multiagente ~15x. El consumo de tokens, por sí solo, explica el 80% de la varianza en el rendimiento de su evaluación de navegación. En sus propias palabras, los multiagente funcionan mainly because they help spend enough tokens to solve the problem: ganan gastando, no por colaboración mágica de varios cerebros.
Ahora el otro lado. En febrero de 2026, el investigador organizacional Jeremy McEntire publicó en SSRN "The Organizational Physics of Multi-Agent AI", y los números duelen: con un solo agente, 28 aciertos en 28 intentos. Con organización jerárquica (un agente delegando en otros), falló el 36%. Con enjambre autorganizado (stigmergy), falló el 68%. Un pipeline de 11 etapas ni siquiera llegó a producir código: agotó el presupuesto en planificación. Su conclusión: "The substrate changes; the physics of coordination at scale remains constant." El sustrato cambia; la física de la coordinación a escala no.
Entre los dos está la taxonomía MAST de UC Berkeley (Why Do Multi-Agent LLM Systems Fail?, ICLR 2025): 1.600+ trazas ejecutadas en 7 frameworks, 14 modos de fallo agrupados en tres categorías:
| Categoría de fallo | % de los fallos observados |
|---|---|
| Especificación ambigua o incumplida | 41,77% |
| Desalineación entre agentes | 36,94% |
| Verificación débil de la tarea | 21,30% |
El fallo que todos imaginan — un agente ignorando al otro — representa 0,17%. Los fallos son organizacionales, no intelectuales: agentes que repiten trabajo, no se detienen, no verifican. ChatDev, la "empresa de software" multiagente, acertó solo 33,33% de las veces.
La síntesis: Anthropic tiene razón cuando la tarea es de búsqueda amplia y paralelizable. McEntire tiene razón cuando los agentes tienen que coordinarse para producir algo único. El error está en pensar que una arquitectura gana siempre.
Lo que cuesta realmente un ejército de agentes
El precio por token es casi siempre el mismo. Lo que cambia es cuántos tokens consume la topología que elegiste. Con los multiplicadores publicados por Anthropic:
| Topología | Tokens vs. un chat | Por tarea ($0.02 base) | 10.000 tareas/mes |
|---|---|---|---|
| Chat simple (sin agente) | 1x | $0,02 | $200 |
| A. Un agente con herramientas | ~4x | $0,08 | $800 |
| B. Orquestador + especialistas encadenados | 4x–8x | $0,08–0,16 | $800–1.600 |
| C. Enjambre paralelo (multiagente) | ~15x | $0,30 | $3.000 |
Sin contar el contexto acumulado: un agente multi-paso con RAG y herramientas ya supera el dólar por tarea, como vimos en cuánto cuesta un agente de IA por tarea.
Aquí va la parte que casi nadie calcula en LatAm: pagas tokens en dólares y facturas en moneda local. Multiplicar por 15 una operación que corre 10.000 veces al mes no es un incremento de costo: es otra categoría de gasto, con otra exposición cambiaria. Antes de discutir arquitectura, discute presupuesto de tokens por tarea.
Por qué los ejércitos fallan: no es inteligencia, es organización
Hay una aritmética que ningún salto de modelo borra. Los agentes son secuenciales y probabilísticos: si cada paso acierta el 95% de las veces, una cadena de 10 pasos termina bien apenas el 59,9% de las veces, y de 20 pasos, el 35,8%. Cada agente que sumas añade otra multiplicación, otra entrega de contexto, otro lugar donde una decisión localmente razonable se vuelve globalmente incorrecta.
Es el mismo patrón que McEntire describe: review thrashing, conflictos de gobernanza, presupuesto agotado en coordinación. Los agentes heredan los modos de falla de las organizaciones humanas. La falla no es del modelo; es del organigrama.
Y la industria ya lo está notando. Gartner (Hype Cycle for Agentic AI, 2026): solo el 17% de las organizaciones ha desplegado agentes de IA, más del 60% espera hacerlo en dos años — la curva de adopción más agresiva que midieron — y proyecta que más del 40% de los proyectos agentic se cancelarán para fines de 2027 por costos crecientes, valor de negocio confuso y controles de riesgo insuficientes. En el mismo ciclo: "fully autonomous agents are not ready for the majority of enterprise use cases today." Deloitte encontró solo 11% con sistemas listos para producción.
Mismo patrón que en por qué falla la mayoría de proyectos de automatización: se automatiza sin proceso en orden y ahora se multiagenteiza sin un agente que funcione.
Las 4 preguntas que deciden la topología
Matriz que usamos antes de escribir una línea de workflow. Responde en orden; la primera que descarte, manda.
| # | Pregunta | Si la respuesta es... | Topología |
|---|---|---|---|
| 1 | ¿La tarea se parte en subtareas independientes que corren en paralelo? | Sí, de verdad (varias fuentes, varios documentos, varios mercados) | Candidato a C |
| No: hay dependencias o un solo resultado | A (un orquestador) | ||
| 2 | ¿Los agentes comparten el mismo contexto o registro (el CRM, la ficha del cliente, el inventario)? | Sí | A — el contexto compartido es dependencia, y Anthropic es explícito: los dominios con muchas dependencias no son buen fit para multiagente |
| 3 | ¿Alguien tiene que escribir (crear, actualizar, cerrar, cobrar)? | Sí | Un solo hilo de escritura. Regla de Cognition: writes stay single-threaded, los agentes extra aportan inteligencia, no acciones |
| 4 | ¿Qué cuesta un error? | Alto (dinero, cliente, cumplimiento) | A con revisión humana, sin importar cuántos agentes uses |
Regla de bolsillo: paralelismo + alto valor por tarea + solo lectura es la única combinación que justifica la topología C.
| Topología | Cuándo la usamos | Qué nunca le damos |
|---|---|---|
| A. Un orquestador con herramientas | Cualquier proceso que toca un sistema de registro: calificación de leads, seguimiento, cobranza, onboarding | — |
| B. Orquestador + especialistas encadenados | Pipelines de lectura con pasos distintos: enriquecer, clasificar, resumir, redactar borrador | Escritura directa desde el especialista |
| C. Enjambre paralelo | Búsqueda amplia: research de mercado, análisis de competencia, lectura de muchos documentos | Cualquier permiso de escritura sobre CRM o facturación |
Cómo elegimos la topología en Mintec
Historia real que ya contamos: conectamos un agente directo al CRM de un cliente de logística vía API. En 72 horas teníamos 14 oportunidades duplicadas, notas de seguimiento inventadas y stages saltando de "calificado" a "cerrado perdido" y de vuelta. No era mala IA: era arquitectura — dos agentes escribiendo sobre el mismo contacto sin capa de orquestación. El caso completo está en agentes de IA en un CRM real.
Desde entonces, el patrón es consistente:
- Procesos que escriben (CRM, facturación, cobranza): un agente, una credencial, una fuente de verdad, reglas deterministas alrededor. La pregunta de quién manda la resolvemos con la regla de tres preguntas de n8n, no agregando agentes.
- Procesos que leen y deciden (calificación de leads, clasificación de respuestas): un orquestador con lógica de reglas + IA — el principio de construir con IA y ejecutar con reglas.
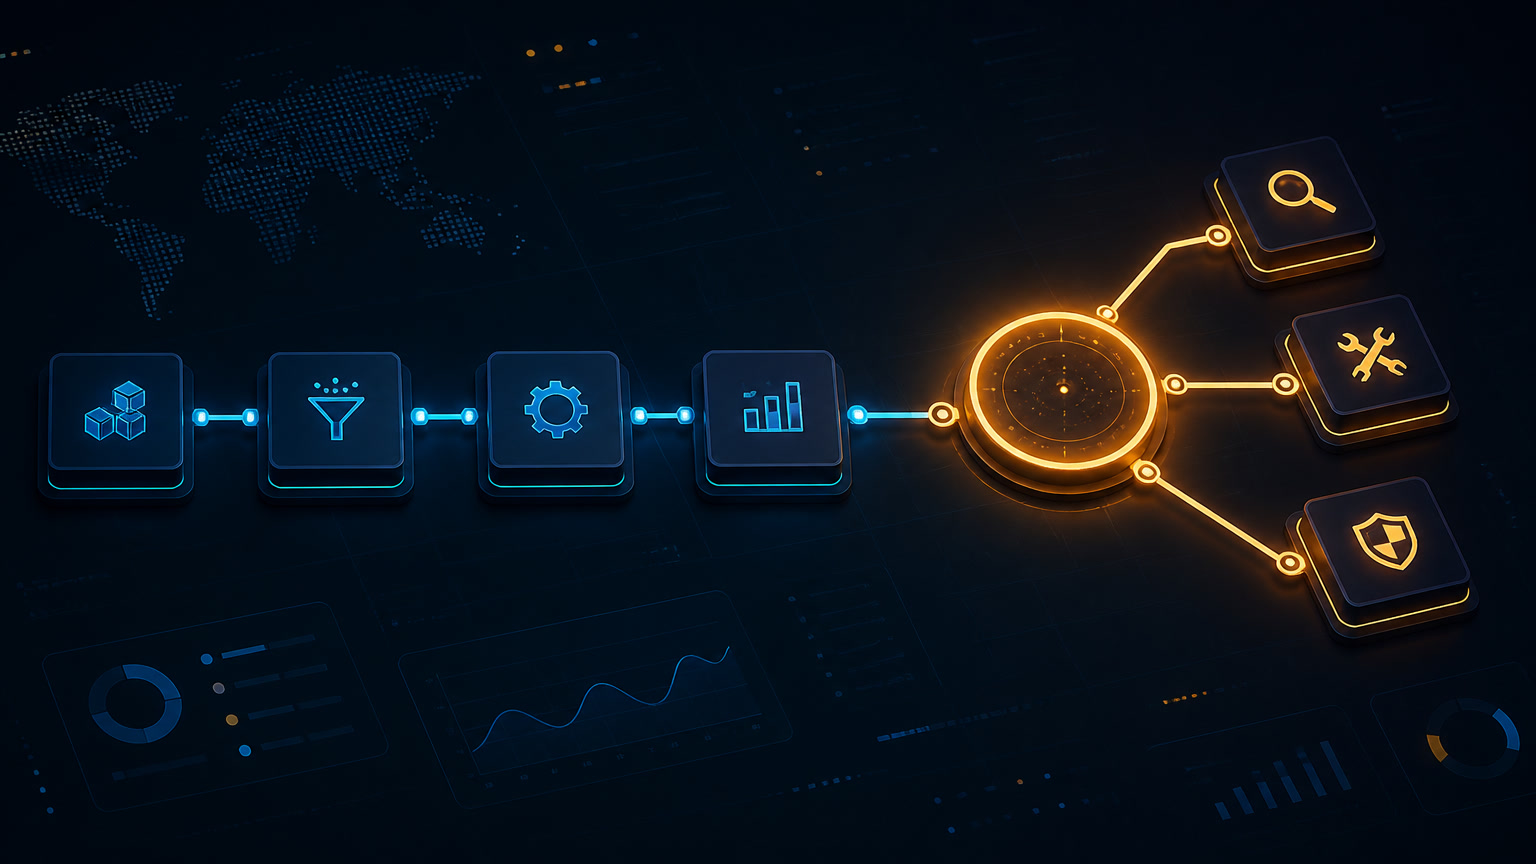
- Procesos de exploración (research, monitoreo competitivo, lectura masiva): aquí sí abrimos subagentes en paralelo, con salida a archivo y sin credenciales de escritura: el único caso donde el multiplicador 15x se paga solo.
Opinión clara: en el 90% de los procesos de clientes en producción, la respuesta es un agente. El enjambre es herramienta de investigación, no de operación. Si tu diagrama tiene diez cajas y una sola tarea paralela, tienes un gasto de organización, no una arquitectura.
Cómo implementarlo sin pagar la lección dos veces
- Un agente, herramientas claras, un registro. Antes de pensar en agentes, ten el proceso estandarizado — el marco de implementación de agentes existe porque el 88% nunca llega a producción.
- Mide desde el día 1 con ~20 casos reales. Los agentes son no deterministas incluso con el mismo prompt: una demo verde es una sola muestra. Reporta tasa de acierto en varias corridas.
- Agrega el segundo agente solo con paralelismo real. Anthropic lo publica: consulta simple = 1 agente con 3–10 llamadas a herramientas; comparación = 2–4 subagentes; research complejo = 10+ con responsabilidades divididas.
- Escritura en un solo hilo, siempre. Si dos agentes pueden modificar el mismo registro, no tienes redundancia — tienes un race condition con lenguaje natural.
- Presupuesto de tokens por tarea y routing de modelos. La palanca más grande de costo no es la topología, es qué modelo atiende qué paso: hasta 60–80% del gasto se recorta con routing.
Tres errores que vemos seguido: contar cajas del diagrama en vez de tareas paralelas; pagar 15x para que un "ejército" resuelva lo que era una regla de dos condiciones; y lanzar sin evaluación, confiando en la primera corrida verde.
La conversación sigue abierta en ese hilo de Reddit. Lo que la mueve no es otra opinión: es cuánto cuesta cada caja y qué pasa cuando se cae.
Fuentes: Anthropic, How we built our multi-agent research system (2025) · McEntire, The Organizational Physics of Multi-Agent AI (SSRN, 2026) · Cemri et al., Why Do Multi-Agent LLM Systems Fail? (UC Berkeley, ICLR 2025) · Cognition, Don't Build Multi-Agents · Gartner, Hype Cycle for Agentic AI 2026 · r/Entrepreneur (54 upvotes, 125 comentarios).
Preguntas Frecuentes
¿Cuántos agentes de IA necesito para automatizar un proceso?
Uno, por defecto. Un orquestador con buenas herramientas y una sola fuente de verdad cubre la mayoría de los procesos de negocio. Agrega un segundo agente solo cuando la tarea sea paralelizable de verdad (varias búsquedas o análisis independientes) y el valor de cada tarea justifique pagar ~4x los tokens de un chat. Los sistemas multiagente rinden ~15x los tokens de un chat, así que solo se justifican en tareas de alto valor con paralelismo real.
¿Cuánto cuesta un ejército de agentes al mes?
Con los multiplicadores publicados por Anthropic (agente ~4x y multiagente ~15x los tokens de un chat), una tarea que en chat simple cuesta $0.02 sale en ~$0.08 con un agente y ~$0.30 con un enjambre. A 10.000 tareas al mes eso son $200, $800 y $3.000 respectivamente. La diferencia no está en el precio por token, está en cuántos tokens consume la topología que elegiste.
¿Cuándo sí conviene usar varios agentes en paralelo?
Cuando la tarea se divide en subtareas independientes (búsqueda de información amplia, análisis de muchos documentos o mercados), el resultado se lee pero no escribe en sistemas de registro, y el valor del resultado paga el sobre de costo. Anthropic lo usa para research de amplio alcance; Cognition recomienda que las escrituras se mantengan en un solo hilo y que los agentes extra aporten inteligencia, no acciones.