El salto a Cloudflare Workers: lo que cuesta de verdad, medido
Mover un sitio de Pages a Workers tiene cuatro dimensiones de costo. Así se mide cada una antes de comprometerte, y qué límites deciden la respuesta.
Mover un sitio estático de Cloudflare Pages a Workers compra margen de archivos, no velocidad — y ese margen es la única línea con un precipicio duro. Corrimos este ejercicio en nuestra propia migración, y lo más útil que produjo no fue una mejora de rendimiento: fue un formato. Cuatro dimensiones de costo, cada una respondible con un número, una herramienta y una fecha. Casi nadie publica un registro con esa forma, y por eso la decisión se sigue discutiendo con adjetivos en vez de mediciones.
Así que esto es el formato del registro, no nuestras cifras privadas: qué anotar en cada dimensión, cómo anotarlo con honestidad y dónde aprietan de verdad los límites de la plataforma.
Por qué el contenido de "qué cambió" no alcanza
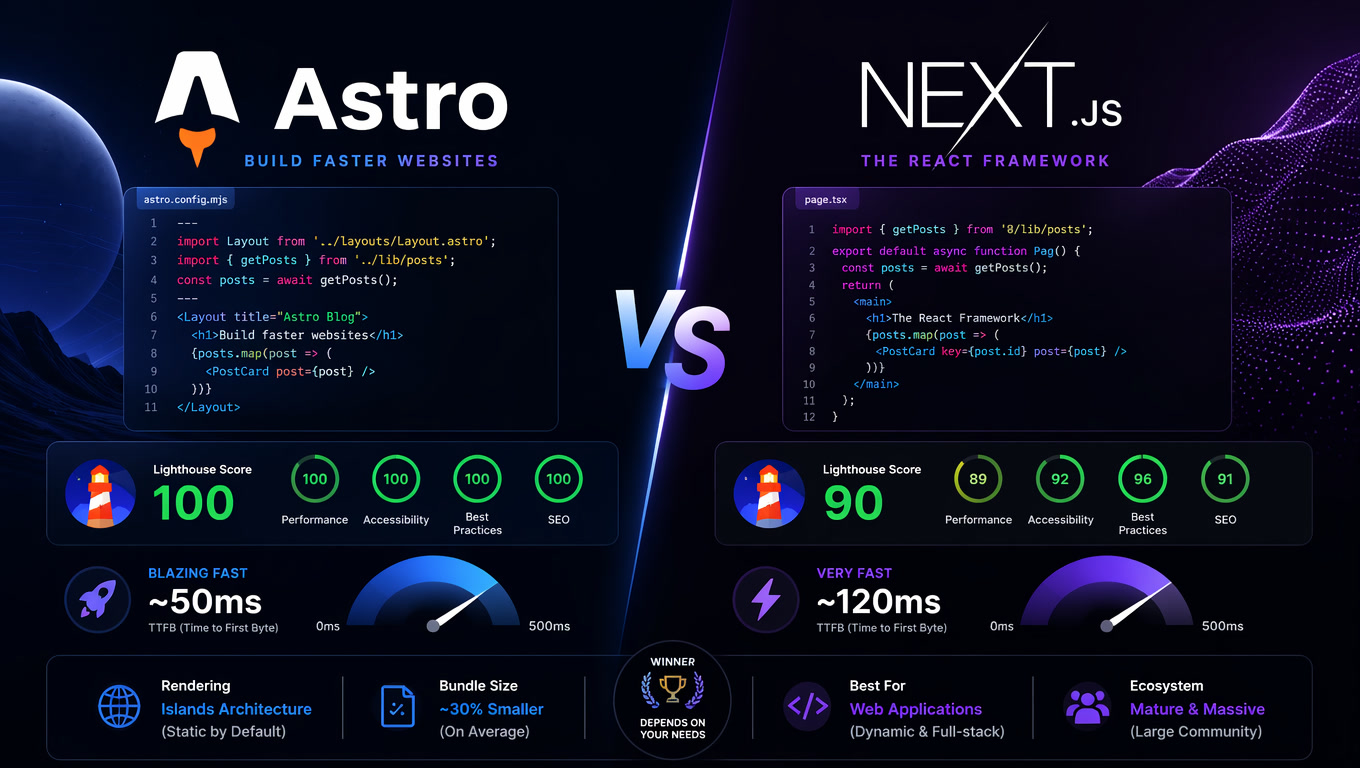
Publicamos el marco de decisión para el salto de Pages a Workers cuando la propia documentación de Cloudflare empezó preguntándote si de verdad querías Pages. Cubrimos la activación por defecto de Node.js en todo Worker. Comparamos Astro y Next.js con benchmarks reales. Todo eso responde qué cambió. Nada responde la pregunta que el comprador técnico realmente lleva a una reunión de presupuesto: ¿cuánto me cuesta esto, en qué dimensión, y dónde se nota?
Una migración tiene cuatro dimensiones de costo. Si puedes llenar las cuatro con números, defiendes la decisión. Si solo puedes llenar "cambiaron los docs", estás adivinando.
| Dimensión de costo | Qué mide | Quién la sufre |
|---|---|---|
| Toolchain | Minutos de build, memoria pico, límites del contenedor de CI | Ingeniería, en cada commit |
| Artefacto | Archivos y bytes por despliegue contra el techo de la plataforma | Quien se choque con el límite a las 2 a.m. |
| Ruta de request | Time to first byte por clase de request | Cada visitante y cada rastreador |
| Rendimiento en campo | Core Web Vitals en el navegador | Conversión, rankings, paciencia |
El registro que hay que armar antes de moverse
El error es medir solo la dimensión que te entusiasma. De estas cuatro, dos suelen salir planas, una es un precipicio y en la otra se esconde el problema real. Anótalas con esta forma:
| Métrica | Cómo capturarla | Cómo se ve una buena respuesta |
|---|---|---|
| Techo de archivos por despliegue | La página de límites de la plataforma, con la fecha en que la leíste | Dos números documentados: el de hoy y el de destino |
| Archivos desplegados | Cuenta el output compilado, no el árbol de fuentes | Un conteo por release y un delta por release |
| Minutos de build y memoria pico | La misma máquina que va a correr el build | Minutos y megabytes reproducibles en un checkout limpio |
| Respuesta del servidor por clase de request | Un punto de medición fijo, con estado de caché por muestra | Una mediana por clase, no un curl con suerte |
| TTFB de laboratorio y vitals de campo | Una corrida de laboratorio que controles; datos de campo cuando haya tráfico | Un par antes/después con la misma herramienta y ajustes |
Lee esa lista y nota qué está diseñada para atrapar: una migración que cambia desde dónde se sirven los bytes, y no los bytes. Nuestra comprobación de paridad existe justamente para eso — probar que una página servida es idéntica byte a byte a su output de build, salvo el beacon de analítica inyectado. Una migración que cambia la entrega y no el payload no debería mover los Core Web Vitals. Si los tuyos se mueven, algo más del pipeline cambió al mismo tiempo, y ya tienes dos variables y un incidente.
La dimensión artefacto: el único precipicio del registro
El techo de archivos es la única línea con un borde duro. Cloudflare Pages limita un despliegue a 20,000 archivos. Los static assets de Workers permiten 100,000 archivos por Worker en plan de pago. Esos son los dos únicos números que necesitas del proveedor — y son los que casi ningún pitch de migración pone en la misma frase.
Lo que importa es tu propia trayectoria. Cuenta el output compilado en cada release, registra el delta y divide el margen restante entre ese delta. La respuesta sale en meses, que es la unidad que de verdad obliga a decidir. Un sitio que suma miles de páginas al mes puede estar dentro del techo hoy y quedarse sin pista antes del próximo plan de contenidos; el mismo sitio con el techo mayor tiene años. Esa es la proporción honesta de costo y beneficio: no te mueves por velocidad. Te mueves cuando un límite documentado de la plataforma es lo que se pone entre tú y el plan de contenidos del próximo trimestre.
Después conecta el número al build para que se anuncie en un pull request y no en un outage. Un guarda que frena el despliegue en una fracción del techo cuesta unas pocas líneas y elimina la versión 2 a.m. de la misma conversación.
La ruta de request: cuánto cuesta de verdad un Worker adelante de todo
Esta es la diferencia arquitectónica que merece un número. Con run_worker_first, un Worker corre antes que los static assets en todas las rutas excepto los prefijos de assets — bundles con hash, imágenes, favicons, robots.txt, llms.txt, rss.xml y los sitemaps. Esos se saltan el Worker por completo. Cada página HTML, cada redirect, cada ruta de API lo invoca.
La pregunta justa es cuánto cuesta esa invocación. La forma honesta de averiguarlo desde una sola máquina es comparar las dos clases de request desde la misma caja, con minutos de diferencia y registrando el estado de caché en cada muestra — HTML manejado por el Worker contra assets que se lo saltan, en el mismo edge. Toma la diferencia como un techo superior y no como una medición de la capa de runtime: no es un A/B controlado, los payloads difieren, y un curl desde un datacenter no es un estudio de campo. Lo que sí te dice con fiabilidad es el orden de magnitud, y el orden de magnitud es el punto: la capa de runtime no es donde se te van los milisegundos.
Un matiz que vale robar: en Pages, el middleware de funciones ya veía esencialmente cada request HTML. La ejecución por request nunca fue gratis — solo se contabilizaba distinto. Si te mueves de una plataforma que ya corría código de servidor por request, no presupuestes una clase de costo nueva. Presupuesta la auditoría que confirma qué rutas todavía la disparan.
La dimensión toolchain: dónde aterrizó de verdad la velocidad
Cloudflare anunció el 20 de octubre tsrs, su port en Rust del compilador de TypeScript, desarrollado con VoidZero: hasta 8× más rápido y cerca de 70% menos memoria que TypeScript 7.0 con el mismo número de workers de chequeo de tipos, integrado al toolchain Oxc en vez de bifurcar TypeScript.
Es un logro de ingeniería real y va a aterrizar en tus minutos de build, no en tu LCP. Un compilador más rápido cambia tu ciclo de edición. Cambia la experiencia del usuario solo si cambia los bytes que envías, el código en la ruta de request o el trabajo en el navegador. Es el error de categoría más común que vemos en los pitches de migración.
Nuestra propia restricción de toolchain resultó ser memoria, no CPU. Un contenedor de build no publica el heap que tu framework va a recibir de verdad, Node deriva su default de la máquina que encuentra, y los dos números se separan en silencio: el build pasa en local, muere a media renderización en CI y producción sigue sirviendo la versión vieja mientras nadie lo nota. El arreglo no es un número más grande prestado de otra máquina; es un tope explícito y medido en el script de build, dimensionado al contenedor que lo ejecuta. Ese es el tipo de número que nunca aparece en un benchmark de proveedor y siempre aparece en tu canal de incidentes.
Cómo tasamos una decisión de framework ahora
El marco tiene cuatro líneas, y la disciplina es que cada línea necesita una herramienta, una fecha y una URL:
- Toolchain — minutos del build de producción, memoria pico y el límite del contenedor donde tiene que caber. Mídelo en la misma máquina donde vas a construir.
- Artefacto — archivos y bytes del output, al lado del techo documentado de la plataforma. Margen en meses, no en porcentajes.
- Ruta de request — TTFB mediano por clase de request, con estado de caché en cada muestra, desde un punto de medición fijo.
- Rendimiento en campo — Core Web Vitals antes y después, con una corrida de laboratorio que controles y, cuando tengas tráfico, datos de campo que no controlas.
Si un proveedor o un benchmark no puede llenar las cuatro, está vendiéndote una dimensión, no una decisión. Así también decidimos qué capas del stack adoptamos y cuáles mantenemos portables — la medida tiene que sobrevivir al pitch.
Nada de esto es motivo para posponer una construcción. Es motivo para registrar tus números antes de cambiar la variable, para que cuando alguien pregunte qué costó la migración respondas con un registro y no con un adjetivo. Si estás frente a una decisión similar y quieres una segunda lectura de las cifras antes de comprometerte, esa es la conversación que tenemos con nuestros clientes — empieza por aquí.
Preguntas Frecuentes
¿Un compilador de TypeScript más rápido o un runtime portado acelera mi producto?
No, no por sí solo. Un cambio de toolchain acelera tu build y tu ciclo de edición. Llega al usuario solo si cambia los bytes que envías, el código que corre en el request o el trabajo de render en el navegador. Mide esos tres por separado, o le vas a acreditar al compilador un trabajo que nunca hizo.
¿Qué se mueve de verdad en Core Web Vitals de un sitio estático?
No el hosting. En un sitio prerenderido el hosting decide el cacheo y el time to first byte, y normalmente ya está dentro del presupuesto. Lo que mueve los Core Web Vitals es el JavaScript de terceros: cuántos scripts cargas, cuánto trabajo hacen en el main thread y cuánto pesan tus imágenes. Cuenta tus peticiones de script antes de culpar a la plataforma.