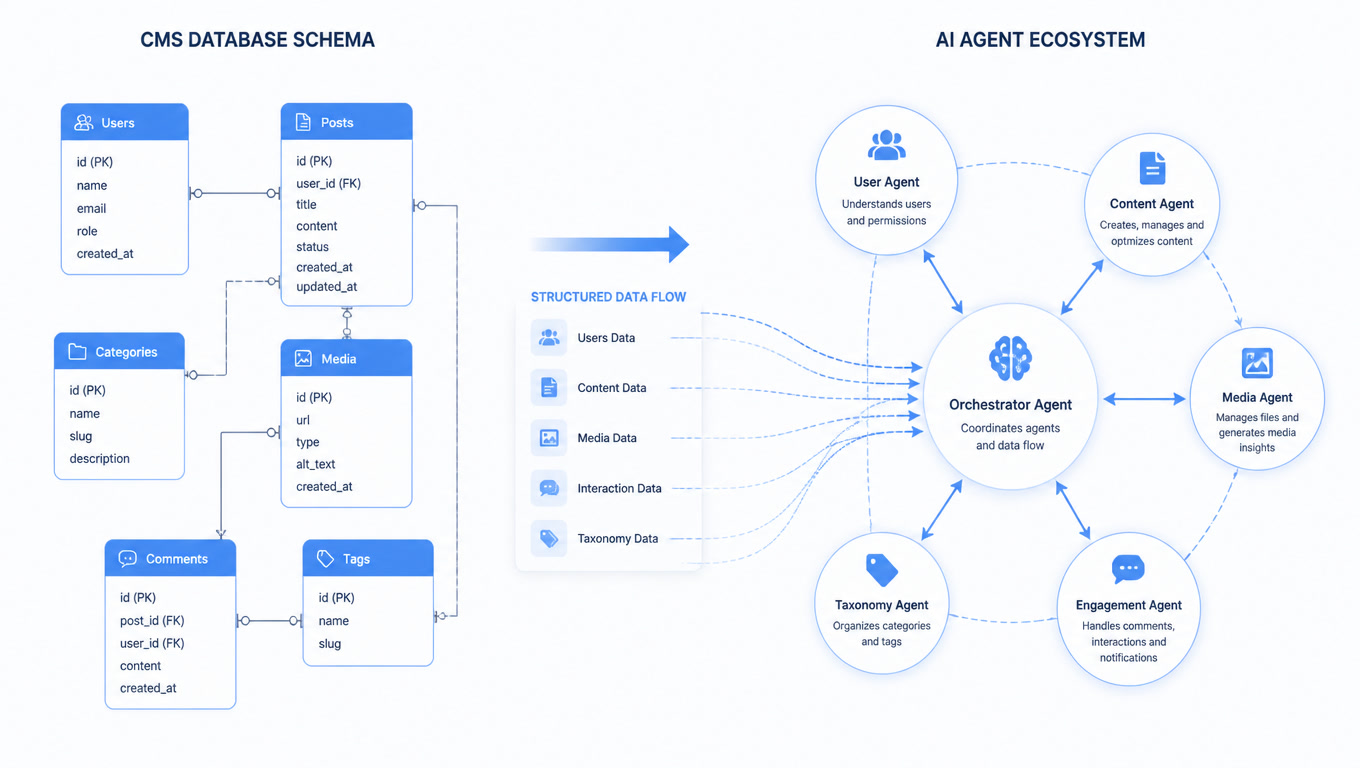
El CMS Agéntico: Por qué tus content models son la nueva infraestructura de AI
Los agentes de AI no son un plugin más — son consumidores de tu contenido. Por qué el diseño de tus schemas, endpoints y modelos de contenido determina si tu stack sobrevive o explota cuando los agentes empiezan a operar.
El CMS Agéntico: Por qué tus content models son la nueva infraestructura de AI
En los últimos 12 meses, cada CMS headless importante ha lanzado capacidades de AI. Sanity tiene MCP. Payload tiene RAG nativo. Storyblok tiene asistentes visuales. Pero la mayoría de los equipos tratan esto como otro feature, no como un cambio arquitectónico que afecta cómo diseñás tu sitio.
En Mintec hemos trabajado con varios de estos stacks — y el patrón que más vemos es equipos que integran agentes de AI sin cambiar la forma en que modelan su contenido. El resultado es predecible: el agente técnicamente funciona, pero la calidad del output es inconsistente, los costos de API se disparan, y terminás con más trabajo de revisión que si lo hubieras hecho manualmente.
El problema no es la tecnología. Es que estás tratando al agente como un usuario humano con permisos de API, cuando en realidad es un consumidor completamente diferente de tu contenido. Este artículo es sobre ese cambio de mentalidad y las decisiones arquitectónicas que importan.
La diferencia entre un CMS con AI y un CMS agéntico
Un CMS "con AI" es lo que la mayoría tiene hoy: un botón de "generar" en el editor, un asistente que sugiere títulos, un plugin que traduce contenido. El agente opera dentro del editor, como un copiloto. Es útil, pero limitado.
Un CMS agéntico es algo distinto. Aquí, el agente opera fuera del editor. Lee esquemas, entiende tipos de datos, crea entradas completas, genera assets, distribuye contenido a múltiples canales — todo programáticamente, sin que un humano toque la interfaz. El CMS no es una herramienta para humanos con features de AI. Es una infraestructura para agentes con un editor para humanos.
La diferencia es arquitectónica, no funcional. Y se resume en una pregunta: ¿puede un agente introspeccionar tu modelo de contenido y entender qué es un "Producto", un "Artículo" o un "Evento"?
Si la respuesta es "sí, porque los schemas están tipados explícitamente y las APIs documentan las relaciones" — estás listo. Si la respuesta es "no, porque el contenido vive en campos de texto libre o en plantillas HTML" — el agente va a operar a ciegas.
Content Lake: el concepto que importa
Sanity popularizó el término "Content Lake" y es la idea central que necesitás entender. Un Content Lake es un repositorio de contenido donde cada pieza está estructurada como datos tipados, no como blobs de HTML. La diferencia:
CMS tradicional: El contenido vive dentro de plantillas. Un agente que necesita encontrar todas las páginas de producto que referencian un SKU descontinuado tiene que parsear HTML, adivinar estructura, y esperar que la plantilla sea consistente. Es como buscar datos en archivos Word.
Content Lake: Cada entrada es un objeto con campos tipados, relaciones explicitas y metadatos estructurados. Un agente puede escribir una query: "dame todos los productos con status='discontinued' que tienen referencias en más de 3 artículos". Eso es una query de base de datos, no un scrape de HTML.
Para equipos de desarrollo, esto significa que la arquitectura de tu CMS ya no es solo una decisión de "cómo guardo contenido". Es una decisión de "cómo expongo datos para que agentes autónomos puedan operar sobre ellos de forma segura y predecible".
Las 3 decisiones arquitectónicas que cambian todo
1. Tipado explícito vs. campos flexibles
El error más común es diseñar content models para la interfaz del editor, no para el consumo programático. Pensás en "qué necesita ver el editor" en vez de "qué necesita entender el agente".
Lo que falla: Un campo "body" de tipo "rich text" que contiene párrafos, imágenes, tablas y videos mezclados. Un agente puede generar texto para ese campo, pero no puede generar la imagen que va dentro, o la tabla que estructura la comparación, porque no sabe que esos elementos existen como entidades separadas.
Lo que funciona: Un campo "body" que es un array de bloques tipados: {type: 'paragraph', text: '...'}, {type: 'image', asset: '...', caption: '...'}, {type: 'comparison_table', rows: [...]}. Ahora el agente puede generar, validar y reemplazar cada bloque individualmente. Y tu CMS puede renderizar cada tipo con la plantilla correcta.
En nuestro último proyecto de migración a Payload para un cliente de e-commerce, el cambio de "un campo rich text" a "un array de bloques tipados" redujo los errores de contenido generado por AI en un 60%. No porque el modelo fuera mejor, sino porque el schema le daba contexto suficiente para generar contenido válido.
2. Relaciones navegables vs. IDs sueltos
Los CMS headless clásicos almacenan relaciones como IDs: author_id: 42. Para un agente, eso es un número sin significado. Necesitás relaciones que el agente pueda introspeccionar.
Lo que falla: Un agente que necesita generar un artículo sobre un producto necesita hacer una query separada para obtener los datos del producto, otra para el autor, otra para las categorías. Cada query es un round trip a la API, y cada round trip tiene costo y latencia.
Lo que funciona: Relations anidadas o populates explícitos que el agente puede solicitar en una sola query: article?populate=[product, author, categories]. El agente obtiene el contexto completo en una llamada, reduce costos de tokens (no necesita generar queries adicionales), y puede tomar decisiones más informadas.
Esto es particularmente relevante cuando usás MCP servers como el de Astro — que expone tus content collections como herramientas que un agente puede invocar directamente. Si tus relaciones están bien modeladas, el agente puede navegar la estructura de contenido sin conocer la implementación interna del CMS.
3. Validación en el schema vs. validación en la presentación
Cuando el agente genera contenido, ¿dónde se valida que sea correcto? La mayoría de los equipos validan en la presentación: "si el contenido se ve bien en la página, está bien". Para agentes, esto es un desastre.
Lo que falla: Un agente genera una entrada de producto sin precio, sin SKU, sin descripción corta. La página se rompe, o peor — muestra datos vacíos que el usuario confía.
Lo que funciona: Validación en el schema: campos requeridos que el CMS rechaza si están vacíos, tipos que rechazan strings donde se esperan números, relaciones que requieren una referencia válida. El agente falla antes de que el contenido llegue al CMS, no después de que ya está publicado.
PayloadCMS hace esto particularmente bien con sus field-level validations. Sanity lo maneja con document-level validation. Storyblok tiene sus component-level restrictions. Independientemente del CMS, el punto es el mismo: tu schema es la línea de defensa entre un agente generando contenido útil y uno generando basura que nadie revisó.
El caso real de los agentes que sobrepasan a los editores
Hay una tendencia que estamos viendo en proyectos reales: equipos que tienen más agentes de AI trabajando en contenido que editores humanos. CosmicJS publicó un artículo sobre "when agents outnumber editors" que toca exactamente este punto.
Cuando tu equipo tiene 2 editores humanos y 5 agentes generando contenido para diferentes canales (blog, redes, email, producto, localización), tu CMS necesita resolver problemas que antes no existían:
- Concurrencia: Dos agentes intentando editar la misma entrada al mismo tiempo. Tu CMS necesita locking o merge strategies.
- Permisos granulares: Un agente puede crear contenido pero no publicarlo. Otro puede traducir pero no editar el original. Los roles de CMS clásicos (admin, editor, viewer) no alcanzan.
- Auditoría: Cuando un agente genera contenido que causa un problema (dato incorrecto, tono inapropiado, violación de marca), necesitás un trail de qué agente hizo qué cambio, cuándo, y por qué. El version history ya no es un feature — es un requisito de compliance.
¿Cuándo migrar y cuándo adaptar?
No necesitás tirar tu CMS actual. Si estás en un headless CMS moderno (Contentful, Strapi, Sanity, Payload, Hygraph) con APIs bien estructuradas, ya tenés la base. Los cambios que importan son de diseño, no de plataforma:
- Audita tus content models con la lente de "¿un agente puede entender esto?". Campos tipados, relaciones explícitas, validaciones en schema.
- Agrega un endpoint de introspección si tu CMS no tiene uno. Los MCP servers como el de Astro做的 exactamente esto — exponen la estructura de tu contenido como herramientas que un agente puede descubrir.
- Implementa validación en schema antes de dar acceso a agentes. Es la diferencia entre contenido generado útil y contenido que hay que reescribir manual.
La migración a un CMS agéntico tiene sentido cuando: operás a escala (más de 10k entradas de contenido), tenés múltiples canales que requieren contenido synchronizado, o necesitás que agentes trabajen en paralelo sin colisionar.
El siguiente paso: agentes que entienden tu arquitectura
Lo que viene es más interesante que los CMS agénticos actuales. Astro ya tiene un MCP server que expone tus content collections como herramientas. Sanity está invirtiendo en MCP y semantic graphs. Payload permite RAG nativo sobre tu base de datos de contenido.
La pregunta no es si tus agentes van a tocar tu stack de contenido. Es si tu stack está listo para que lo hagan. Un CMS agéntico no es un feature — es una postura arquitectónica. Y el momento de adoptarla es antes de que la necesites, no después de que tus agentes estén generando contenido que no podés controlar.
En Mintec ayudamos a equipos a diseñar content models que funcionan tanto para humanos como para agentes de AI. Si estás evaluando una migración a un CMS agéntico o querés auditar tus schemas actuales, hablemos.
Preguntas Frecuentes
¿Qué es un CMS agéntico?
Un CMS agéntico es un headless CMS diseñado para que agentes de AI autónomos puedan leer, crear, editar y distribuir contenido a través de APIs estructuradas. No es un chatbot pegado a un editor — es una infraestructura donde los schemas del CMS actúan como reglas de negocio, las APIs como controles y el version history como safety net. Sanity, Payload y Storyblok lideran esta categoría.
¿Cómo afecta un CMS agéntico al diseño de content models?
Cuando un agente consume tu contenido, cada campo del modelo se convierte en una superficie programable. Los campos deben ser tipados explícitamente, las relaciones entre entradas deben ser navegables, y los schemas deben documentar qué campos son requeridos vs. opcionales. Un agente no puede inferir que 'hero_image' es un campo de imagen — necesita que el schema lo declare con tipos, validaciones y restricciones.
¿Necesito migrar a un CMS agéntico?
No necesariamente. Si tu CMS headless actual expone APIs estructuradas con schemas bien definidos, ya tienes la base. El cambio real está en cómo diseñás tus content models: tipado explícito, relaciones navegables, campos validados. La migración a un CMS agéntico tiene sentido cuando necesitás operaciones de contenido a escala con múltiples agentes trabajando en paralelo.